dimanche 30 août 2015

Expression de table communes (common table expression, CTE)

Depuis SQL Server 2005, il existe une fonctionnalité puissante qui permet au programmeur d'alléger et de simplifier les requêtes, tout en facilitant la maintenance et le déboggage. Cette fonctionnalité est les expressions de table communes, communément appelé CTE (Common table expression).

Les CTE nous permettent de définir des ensemble de données temporaires qui seront utilisés dans la requête. On peut comparer un CTE à une vue ou à une table dérivée dont la durée de vie n'excèdent pas le temps d'exécution de la requête.

Pour construire notre CTE, on doit utiliser le mot-clef “WITH” suivi du nom de l'expression, des colonnes retournée ainsi que de la définition de l'expression. Une fois définie, il ne suffit plus que d'écrire la requête comme à l'habituel en utilisant le nom de CTE comme si c'était une table ou une vue.

Par exemple, supposons que nous voulons connaître les employés de 50 ans et plus qui travaillent de soir. Nous pouvons diviser l'ensemble de données de la base de donnes AdventuresWorks en deux parties distinctes, soit les employées qui ont plus de 50 ans et les employés qui travaillent de soir, puis joindre ces deux ensembles de données pour obtenir le résultat désiré.


En définissant les CTEs, nous augmentons la lisibilité du code et il nous est plus facile d'effectuer la maintenance et le déboggage en focusant sur le résultat d'une expression plutôt que sur l'ensemble de la requête.

La définition des CTEs peuvent contenir des instructions beaucoup plus complexes comprenant, entre autre, les fonctions de partitionnement de données, comme les fonctions ROW_NUMBER et RANK.

À présent, supposons que nous voulons connaître quels produits se sont vendus par mois, et en quelle quantité. Nous voulons aussi connaître quel a été le meilleur vendeur du produit pour le mois donné.

Pour commencer, nous définissons un premier ensemble de données, ArticleVendusParAnnéeMois, qui contient la quantité de produits vendus par mois.

Le deuxième ensemble de données, ArticleVenduParAnnéeMoisVendeur, contient la quantité de produits vendus par vendeur. On utilise ici la fonction ROW_NUMBER() pour numéroter les vendeurs en fonction du nombre d'item vendu par produit pour un mois donné.

La requête qui suit nous permet d'utiliser ces données pour obtenir le résultat voulu. Ici, nous appliquons un filtre “v.Rang = 1” pour ne faire sortir que les meilleurs vendeurs par produit vendu par mois.


Référence:


dimanche 23 août 2015

Déterminer les indexes manquants dans notre base de données

Lorsque l'exécution de nos requêtes deviennent de plus en plus longue à être exécutées, c'est souvent un signe d'une mauvaise stratégie d'implémentation d'index d'une base de données sur les tables que nos requêtes utilisent.

Pour nous aider, SQL Server nous expose trois vues de gestion dynamique (DMV: Dynamic management view) qui nous indiquent quelles tables auraient besoin d'index, avec quels champs et quels bénéfices on en tirerait en ajoutant ces index.

Petite note importante, comme toutes les vues de gestion dynamique, elles sont réinitialisées à chaque redémarrage du serveur. Aussi, pour vous aider dans votre stratégie d'implémentation d'index, il est important d'exécuter ces requêtes sur le serveur de production plutôt que sur un serveur de développement ou de test. En faisant cela, on s'assure que le résultat de nos requêtes refléteront la réalité de la production plutôt que d'être influencé par des requêtes de déboggage en développement ou ne pas bien refléter la charge de travail réelle en se basant sur l'environnement de test seulement.

sys.dm_db_missing_index_detail
Cette vue nous indique la table et les colonnes qui bénéficierait d'un index. Cette vue sépare les colonnes en trois types bien distinct : les colonnes d'égalités, les colonnes d'inégalité et les colonnes d'inclusions. Lors de la création d'un index, on prendra soin de spécifier les colonnes d'égalités en premier, suivi des colonnes d'inégalités. Les colonnes d'inclusions nous indiquent les colonnes à inclure dans la création de l'index, avec la clause INCLUDE.

sys.dm_db_missing_index_group_stat
Cette vue nous indique les bénéfices que l'index apporterait en fonction des requêtes effectuées depuis le dernier démarrage du serveur SQL. Les colonnes qui nous importeront le plus sont les colonnes user_seeks, user_scans, avg_total_user_cost, avg_user_impact ainsi que leur contrepartie système system_seeks, system_scans, avg_total_system_cost et avg_system_impact.

Les colonnes user_seeks et user_scans nous indique le nombre de fois qu'un requête a eu besoin de faire un recherche direct (user_seek) ou un balayage (user_scans) des données. La colonne avg_total_user_cost nous indique la réduction du coût de la requête si l'index existerait et la colonne avg_user_impact nous donne un indice de la réduction, en pourcentage, du coût de la requête. Lorsqu'on décidera d'implémenter un index plutôt qu'un autre, on devrait tenir compte de ces informations.

sys.dm_db_missing_index_groups
Cette vue est seulement une vue d'association entre les bénéfices de l'implémentation d'un index et des colonnes de ce dernier.

À titre d'exemple, je prends le petit script suivant pour démonter comment on peut améliorer les performance grace à l'indexation d'une table.

Au départ, le script créer la base de données « SQLQuébec » ainsi que le schéma « SQLQuébec » si ceux ci n'existe pas. Ensuite, le script crée une table « SQLQuébec.TestIndexManquant » qui contiendra un million d'enregistrements sans aucun index pour continuer par une première boucle de mille requêtes seulement, question de ne pas faire rouler la requête trop longtemps inutilement.

On affiche ensuite le temps d'exécution pour ces mille requêtes ainsi que les informations des vues SQL Server pour connaître les bénéfices qu'on pourrait avoir en implémentant un index.

Ensuite, on créer l'index de façon dynamique en interrogeant les les vues et on exécute une deuxième boucle, d'un millions de requêtes cette fois ci.

Les résultats peuvent varier selon les configurations du serveur SQL et de la charge du serveur lors de l'exécution des requêtes. Lors de l'exécution du script sur mon serveur SQL, on voit que les premières mille requêtes sans index se sont exécutées en 32 secondes, alors que un millions de requêtes sur la même table se sont exécutées en 10 secondes. En extrapolant avec la bonne vieille règle de 3, on peut dire que 1 000 000 de requêtes sur la table sans index aurait pris près de 9 heures à s'exécuter, tandis qu'avec un index, il nous a fallu seulement 10 secondes pour exécuter le million de requêtes.


Références : 


dimanche 16 août 2015

Recherche avancée avec like et expression

Lorsque nous avons besoin de rechercher des données selon un certain patron, l'opérateur LIKE nous est bien utile. Même si elles ne sont pas aussi riches que les expressions régulières, avec SQL Server, nous pouvons utiliser des expressions pour définir les patrons de recherche. Les caractères de recherche les plus connus sont les suivants:

Caractères
Définition
% Match un ou plusieurs caractères
_ Match un caractère
[...] Match un caractère parmis la liste spécifiée
[^...] Match un caractère qui n'est pas parmi la liste spécifié


Par exemple, si on prendre la table DatabaseLog de la base de données AdventureWorks, si on veut rechercher l'ensemble des requêtes SQL qui ont modifiées la table Address, on exécutera la requête suivante :


Comme on voit, la requête n'est pas efficace puisqu'elle retourne pas seulement les enregistrements qui touche la table "Address", mais l'ensemble des requêtes qui contiennent le mot "Address", comme par exemple "AddressType", "BusinessEntityAddress" ou même "EmailAddress". Pour corriger le tir, on peut tenter de décorer le mot "Adresse" de crochet:


Le résultat est pire, nous obtenons des enregistrements qui ne contiennent pas du tout le mot "Address" puisque les caractères "[" et "]" ont une signification spéciale. SQL Server va tenter de matcher un des caractères de "Address" dans l'ensemble des données.


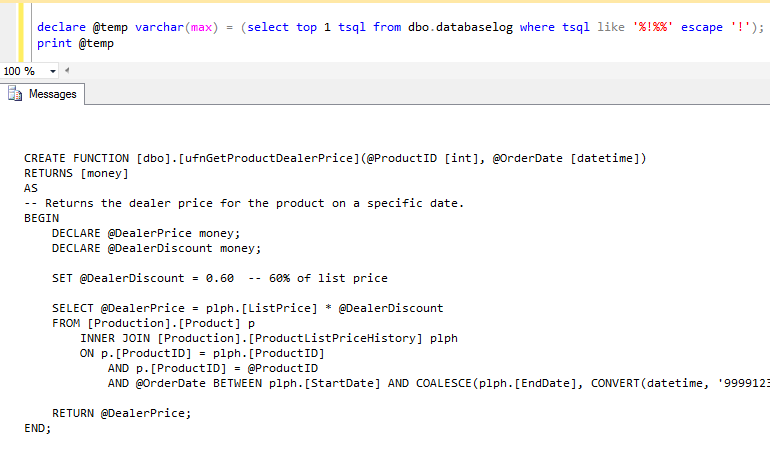
Pour avoir le bon résultat, il faudra utiliser une clause qui est un peu plus méconnu, soit la clause "ESCAPE". Cette clause permet de définir un caractère d'échappement qui va nous permettre de recherche le bon patron. Pour notre exemple, nous allons utiliser le caractère "!" comme caractère d'échapement, mais n'importe quel caractère peut faire l'affaire.


De la même façon, on peut aussi rechercher dans la table DatabaseLog les requêtes SQL qui ont utilisées le caractère "%".


Maintenant que nous connaissons la clause ESCAPE, à quoi peut-elle vraiment nous servir et quand on doit s'en servir?

Il n'est pas rare qu'une application, web ou non, offre à l'utilisateur la possibilité de faire une recherche dans les données. Avec la clause ESCAPE, nous pouvons offrir la possibilité à l'utilisateur de faire des recherches dans les données, sans interférer avec les caractères spéciaux. Pour ce faire, il suffit de préfixer les caractères spéciaux présent dans la chaînes de recherche avec un caractère d'échappement.


Afin de limiter les efforts relié à l'écriture, on peut aussi se créer une procédure qui nous permettra de rechercher un patron dans un champ en particulier. Ce qui a de spécial, dans ce cas-ci, c'est qu'il ne faut pas oublier de doubler les apostrophes étant donné qu'on se sert de SQL dynamique.


dimanche 9 août 2015

Exportation rapide des données vers un fichier de script SQL

Souvent, lors du développement ou de l'entretien, on a besoin d'une méthode facile pour exporter les données d'une table vers un fichier de script. SQL Server Management Studio nous offre la possibilité de script l'insertion des données en peu de clics.

Premièrement, vous devez cliquer avec le bouton droit sur la base de données et choisir "Task\Generate Scripts" dans le menu contextuel.


Vous sélectionnez ensuite la ou les tables à scripter.


Vous sélectionnez ensuite les options selon vos besoins, si vous voulez le script dans un fichier ou dans une nouvelle fenêtre de requête SSMS, entre autre.


Vous devez cliquer sur le bouton "Advanced" afin de définir les options avancés et de définir l'option "Types of data to script" à "Data only".


Et voila, SSMS a créé un script qui contient des INSERT pour chaque enregistrement de la table.


Une méthode facile pour scripter nos données et faciliter les migrations!