Aucun message portant le libellé expression de table commune. Afficher tous les messages

dimanche 1 novembre 2015

TOP X pour chaque groupe de données


Que ce soit les 10 chansons les plus vendus par style de musique dans une boutique en ligne, les 3 meilleurs pointeurs par équipes, les 5 dernières nouvelles par catégories, il y a des cas où on veut dans nos rapport un nombre prédéfini de résultat selon un groupe de données en particulier. Malheureusement, SQL Server ne nous donne pas un outil ou instruction pour le faire de façon simple et efficace.

Qu'à cela ne tienne, on peut contourner cette limitation en employant l'un ou l'autre des techniques ci-dessous.

Technique de la numérotation

La première technique consiste à numéroter chaque ligne de résultat selon le groupe de données désiré puis d'y appliquer un filtre sur les numéros pour ne retourner que les X résultats souhaités par sous-groupe de données.

Par exemple, disons que nous voulons connaitre les trois produits qui se sont le plus vendus par années pour la compagnie AdventureWork. Il faudra tout d'abord construire une requête pour numéroter le résultat.


Ensuite, on y applique un filtre pour ne retourner que les valeurs désirées.


Voila, un top 3 des meilleurs vendeurs par année.

Cette technique fonctionne bien sur des jeux de données plus ou moin petit. Lorsque le volume de données devient considérable, et surtout si le nombre de valeurs distinctes reste significativement petit comparer à l'ensemble des données, la deuxième technique peut s'avérer plus rapide et plus efficace.

Technique de l'APPLY

En reprenant l'exemple lors de la technique par numérotation, la technique du cross apply consiste à utiliser l'opérateur APPLY pour calculer le top 3 des meilleur vendeurs selon l'année présente dans un premier jeu de données.

Pour commencer, il faut se construire un jeu de données qui ne contient que les valeurs distinctes qui constituent notre groupe de données distinct.


Avec ce petit jeu de données, on applique l'opérateur APPLY pour calculer le top 3 des meilleurs vendeurs selon l'année.


Cette requête prends un temps d'exécution considérable, compte tenu du temps d'exécution de la première technique. On peut améliorer ce temps d'exécution en se créant une table commune pour réduire le nombre d'enregistrements qui appelleront l'opérateur APPLY.


Avec cette nouvelle version, le temps d'exécution s'est grandement amélioré pour rejoindre celui de la première technique.

Mais peu importe la technique que vous utilisez, il restera important tester la performance en fonction de votre jeu de données.


Références:


dimanche 25 octobre 2015

Produit Scalaire (ou fonction de multiplication d'agrégation)

Lorsqu'on veut implémenter une certaine logique qui implique, notamment, de faire la multiplication sur un ensemble d'enregistrement, on se retrouve vite pris au dépourvu sans l'aide d'une fonction d'agrégation comme la fonction SUM qui nous permettrait de faire la multiplication d'un champs sur un ensemble d'enregistrements.

Qu'à cela ne tiennent, il existe des techniques pour surmonter ce problème.

Technique des logarithmes
La première façon de faire est d'utiliser les propriétés logarithmiques. Les deux propriétés qui nous intéressent sont les suivantes :

  • log (a * b) = log (a) + log (b)
  • exp(log(a)) = a


Avec la première propriété, on peut transformer la multiplication en sommation, et avec la deuxième propriété, on peut retrouver le résultat de la multiplication.

Pour démontrer cette solution, prenons par exemple un jeu de données comprenant les valeurs de 1 à 5.


Pour obtenir le résultat de la multiplication en utilisant les propriétés logarithmiques, il suffit de faire la requête suivante


Cette méthode est simple et efficace, mais elle a l'inconvénient d'ajouter un facteur d'erreur dans le résultat. Même si on multiplie des valeurs de type entière, le fait qu'on utilise la fonction LOG et que celui-ci nous retourne un type FLOAT et qu'ensuite, on utilise cette valeur de type FLOAT en paramètre à la fonction EXP qui nous retourne aussi un type FLOAT fera en sorte qu'il existe la possibilité d'arrondissement et ainsi, fausser le résultat.

Technique de la récursivité
Une autre technique consiste à utiliser les CTE et la récursivité pour multiplier les différentes valeurs.

Prenons encore notre ensemble de données avec les valeurs de 1 à 5. Nous construisons ensuite un CTE qui permet de calculer la multiplication entre le chiffre courant et la valeur, déjà multipliée, précédente.


Cette méthode est un peu moins simple que la première, mais elle a l'avantage de ne pas introduire un facteur d'erreur d'arrondissement pour les données de type entière. Il faut néamoin s'assurer de prendre la dernière valeur calcul, d'où le "SELECT TOP 1 ..... ORDER BY id DESC".

Par contre, elle introduit une nouvelle limitation, soit celle du nombre maximal de récursion dans la requête. Par défaut, le nombre maximal est de 100.


Si le nombre de récursion se doit d'être plus élevé, on peut soit utiliser l'option MAXRECURSION ou utiliser la technique "diviser pour régner", mais peu importe la technique choisi, il faudrait aussi tenir compte du type de donnée et s'assurer que le type soit capable de contenir la valeur de retour et ainsi éviter les débordements.

Pour l'option MAXRECURSION, il suffit simplement d'écrire l'option à la fin de l'instruction FROM.


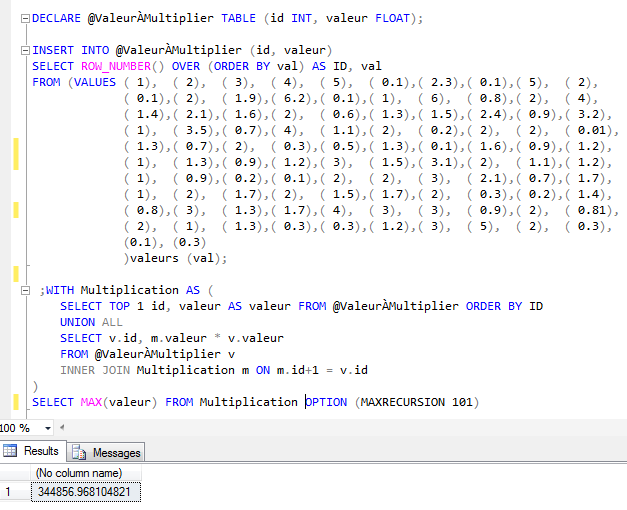
Il est très rare qu'on sache à l'avance le nombre d'enregistrements qu'on devra multiplier ensemble. Pour contrer cette problématique, puisque la multiplication est associative (on peut interchanger les positions sans problèmes), on peut séparer notre ensemble de valeur à multiplier en différentes parties qui seront multipliées entre eux pour ensuite multiplier les résultats et ainsi former notre résultat final.

Pour diviser notre ensemble en sous-ensemble, nous effectuons une division entière de l'id unique par le nombre maximal de valeur qu'on veut par couche jusqu'à un maximum de 100, soit la limite supérieur de récursion. Dans notre exemple avec 102 valeurs, nous divisons notre ensemble par couche de 5 valeurs pour avoir plus d'une partition.


Une fois nos partition créées, il suffit de boucler dans notre second ensemble de données pour multiplier l'ensemble des partitions et obtenir notre résultat final


dimanche 11 octobre 2015

Les fonctions analytiques de SQL Server

Peu connues, SQL Server offre quelques fonctions analytiques qui permettent d'obtenir plus d'informations sur l'ensemble de données qui est traité. De les huit différentes fonctions analytiques que SQL Server nous fournis, on peut les diviser en deux catégories: les fonctions analytiques de positionnement et les fonctions analytiques sur la distribution des valeurs.

Pour démontrer chacune des fonctions, je vais prendre le même ensemble de données, soit le total des items vendus par mois ainsi que le total des ventes mensuel de la base de données AdventureWorks. Pour restreindre le jeu de données et pour ne pas être submergé de données, je vais limiter les ventes qu'aux années 2011 et 2012. La requête utilisée pour nous donner le jeu de données est la suivante.


Fonctions analytiques de positionnement

SQL Server offre 4 fonctions analytique pour connaitre les différentes valeurs des enregistrements précédents ou suivants. L

FIRST_VALUE

Comme son nom l'indique, cette fonction nous donne la valeur du premier enregistrement selon l'ordre spécifié ainsi que selon le partitionnement des données. Cette valeur n'est pas nécessairement la première valeur retournée dans le résultat, mais bien la première valeur selon la clause OVER qui est spécifié. Par exemple, on veut avoir la première valeur des items vendu par mois, ordonnancé par mois


Comme on a ordonnancé par mois seulement et que le plus petit mois est 1, on a donc cette valeur, soit 3967. Par contre, si on veut la première valeur par année, il faut partitionner nos données par année.


En partitionnant nos données, la première valeur est calculée pour chaque partitionnement en prenant la valeur associé au mois le plus petit, soit le 5ième mois pour l'année 2011 et pour le premier mois de 2012.

LAG

La fonction LAG nous permet de connaitre les valeurs précédentes à l'enregistrement courant. Par défaut, la fonction LAG retourne la valeur précédente, mais on peut aussi lui indiquer la n-ième valeur que nous souhaitons connaitre. Lorsque la valeur demandée n'existe pas, la valeur NULL est retournée.

Ainsi, dans notre exemple, on peut connaitre le nombre d'items vendus pour les mois précédents.


LEAD

De la même façon que la fonction LAG, la fonction LEAD permet de connaitre les valeurs suivantes à l'enregistrement courant. Ainsi, dans notre exemple, on peut connaitre le nombre d'items vendus pour les mois suivants.


LAST_VALUE

La dernière fonction analytique de positionnement est la fonction LAST_VALUE qui est sensiblement comme la fonction FIRST_VALUE, mais qui comporte une petite spécifité qui peut en mystifier plus d'un.

On se rappel que, lorsqu'on a calculé la FIRST_VALUE plus tôt, nous avons partionné nos données par année pour avoir une valeur correspondant à la première valeur par année.

Sans partitionnement


Avec partitionnement


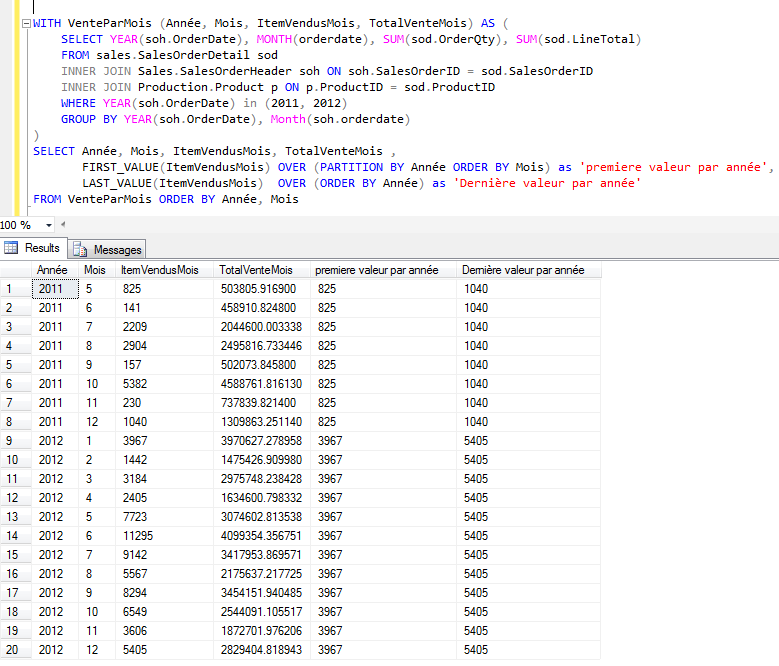
Pour la fonction LAST_VALUE, c'est différent. Voyons ce qu'il arrive lorsqu'on utilise la même clause OVER que pour FIRST_VALUE


On remarque que pour FIRST_VALUE, on a bien la bonne valeur, mais pour LAST_VALUE, on a la même valeur que pour ItemVendusMois. Et cette valeur peut nous mystifier un peu plus si nous omettons la clause PARTITION BY où il semble prendre n'importe quelle valeur.


Dans les faits, LAST_VALUE calcule la dernière valeur en fonction de la clause PARTITION BY ainsi que pour chaque valeur distinctes de la clause ORDER BY. Dans notre exemple, comme on veut la dernière valeur de l'année, on doit ordonnancer par année, ce qui nous donnera la bonne valeur.


On peut valider ceci en prenant des valeurs arbitraires pour y appliquer la fonction LAST_VALUE.

Par exemple, dans la requête suivante, on se créer des couples de données (A,B) pour en calculer la dernière valeur. On remarque que dans la dernière colonne (LAST_VALUE ORDER BY A), on a la valeur B qui est associé à la dernière occurence de la valeur A (les enregistrements bleutées).


À l'inverse, lorsqu'on trie par B pour avoir la dernière valeur de A, on a le même phénomène. Pour chaque valeur distinct de B, on a la valeur de la dernière occurence de A.


Fonctions analytiques sur la distribution des valeurs

Les quatres dernières fonctions permettent d'avoir des informations quant à la distribution des données. Les fonctions PERCENTILE_CONT et PERCENTILE_DISC permettent d'obtenir le percentile d'une distribution de données tandis que les fonctions CUME_DIST et PERCENT_RANK permettent de déterminer le rang de la donnée relativement à la distribution.

PERCENTILE_CONT et PERCENTILE_DISC

Les fonctions PERCENTILE_CONT et PERCENTILE_DISC permettent de calculer le percentile d'une distribution basé sur un ordonnancement et une partition de données spécifiée. La différence entre ces deux fonctions est que, pour la première, il va traiter la distribution numérique comme étant une distribution continu, qui peut prendre une infinité de valeur, tandis qu'avec la fonction PERCENTILE_DISC, il traite la distribution comme étant un ensemble de valeurs discrètes et fini. Dans le premier cas, la valeur retournée peut ne pas exister dans la distribution tandis que dans le deuxième cas, la valeur retournée doit obligatoirement exister dans la distribution.

Dans le cadre de notre exemple avec les items vendus par mois, on peut calculer le 33ième percentile de chaque année de cette façon :


Dans le résultat, on peut affirmer que, dans le cas d'une distribution continu, 35% des données sont égal ou en deça de 497.75, tandis que dans une distribution discrète, 35% des données sont égal ou en deça de 230

CUME_DIST et PERCENT_RANK

Ces deux fonctions permettent de calculer la position relative en pourcentage de l'occurrence courante par rapport à l'ensemble du jeu de données.

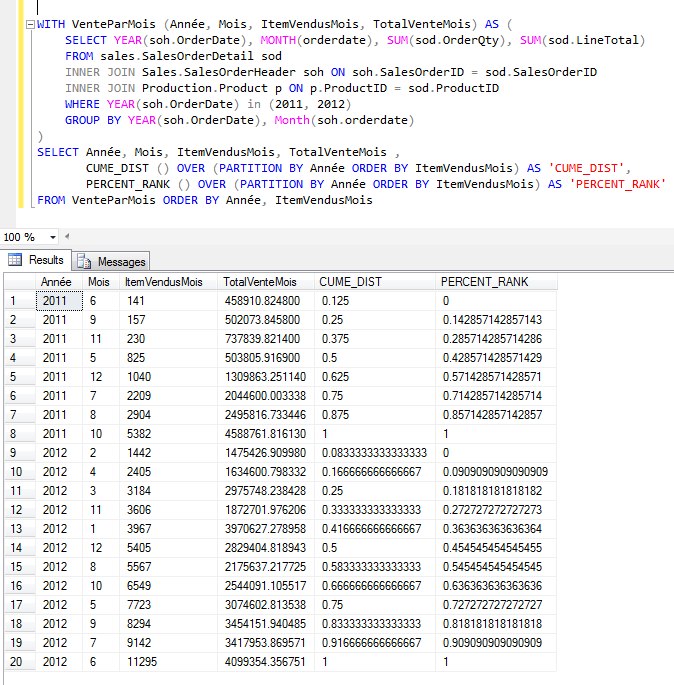
La fonction CUME_DIST (distribution cumulative) permet d'obtenir la position relative par rapport au jeu de données où la valeur retournée indique le pourcentage de valeur qui est égale ou inférieur à la valeur courante. De façon plus concrète, la valeur retournée est égale à r/n où r la position de l'occurrence courante et n est le nombre total du jeu de donnée.

La fonction PERCENT_RANK permet aussi de calculer le rang relative de l'occurrence courante par rapport au jeu de donnée, mais la première ligne aura toujours la valeur zéro.

On peut voir les différences entre ces deux fonctions dans le résultat suivant :


Références:


dimanche 6 septembre 2015

Séparation d'une chaîne de caractères en jetons

Un jour ou l'autre, on a tous besoin de séparer une chaîne de caractères en jetons. Que ce soit parce que l'on recoit en paramètre une liste d'identifiant ou une liste d'article, il nous faudra découper cette chaîne en différents jetons pour exécuter notre traitement.

SQL Server ne nous offre pas de fonctionnalité de base pour découper une chaîne de caractères selon un caractère de séparation, comme le fait String.Split sur la plateforme .NET, ou comme la fonction strtok en C. Par contre, il existe une technique toute simple en SQL qui nous permet de le faire.

La technique consiste à se créer une table temporaire contenant toutes les positions du caractère de séparation, puis à y appliquer le découpage de la chaîne en fonction de cette table.

Prenons par exemple les 10 premiers produits de la table Production.Product de la base de données AdventureWorks.


Pour séparer cette chaîne, nous allons nous construire une table contenant les positions du caractère ',' en utilisant une expression de table commune recursive.


La petite particularité que nous avons ici est que, pour le dernier enregistrement, nous avons la valeur 0 comme position de fin. Pour contourner ce petit problème, on utilise l'instruction CASE WHEN pour remplacer la valeur zéro par l
a longueur de la chaine, puis on utilise le tableau comme valeur d'entrée à la fonction SUBSTRING en prenant bien soin de supprimer les espaces superflus qui peuvent avoir au début et à la fin de la chaîne de caractères


Si l'ordre est jeton est nécessaire, on peut ajouter la position dans la table temporaire pour nous aider à retrouver un jeton en particulier.


Références:


dimanche 30 août 2015

Expression de table communes (common table expression, CTE)

Depuis SQL Server 2005, il existe une fonctionnalité puissante qui permet au programmeur d'alléger et de simplifier les requêtes, tout en facilitant la maintenance et le déboggage. Cette fonctionnalité est les expressions de table communes, communément appelé CTE (Common table expression).

Les CTE nous permettent de définir des ensemble de données temporaires qui seront utilisés dans la requête. On peut comparer un CTE à une vue ou à une table dérivée dont la durée de vie n'excèdent pas le temps d'exécution de la requête.

Pour construire notre CTE, on doit utiliser le mot-clef “WITH” suivi du nom de l'expression, des colonnes retournée ainsi que de la définition de l'expression. Une fois définie, il ne suffit plus que d'écrire la requête comme à l'habituel en utilisant le nom de CTE comme si c'était une table ou une vue.

Par exemple, supposons que nous voulons connaître les employés de 50 ans et plus qui travaillent de soir. Nous pouvons diviser l'ensemble de données de la base de donnes AdventuresWorks en deux parties distinctes, soit les employées qui ont plus de 50 ans et les employés qui travaillent de soir, puis joindre ces deux ensembles de données pour obtenir le résultat désiré.


En définissant les CTEs, nous augmentons la lisibilité du code et il nous est plus facile d'effectuer la maintenance et le déboggage en focusant sur le résultat d'une expression plutôt que sur l'ensemble de la requête.

La définition des CTEs peuvent contenir des instructions beaucoup plus complexes comprenant, entre autre, les fonctions de partitionnement de données, comme les fonctions ROW_NUMBER et RANK.

À présent, supposons que nous voulons connaître quels produits se sont vendus par mois, et en quelle quantité. Nous voulons aussi connaître quel a été le meilleur vendeur du produit pour le mois donné.

Pour commencer, nous définissons un premier ensemble de données, ArticleVendusParAnnéeMois, qui contient la quantité de produits vendus par mois.

Le deuxième ensemble de données, ArticleVenduParAnnéeMoisVendeur, contient la quantité de produits vendus par vendeur. On utilise ici la fonction ROW_NUMBER() pour numéroter les vendeurs en fonction du nombre d'item vendu par produit pour un mois donné.

La requête qui suit nous permet d'utiliser ces données pour obtenir le résultat voulu. Ici, nous appliquons un filtre “v.Rang = 1” pour ne faire sortir que les meilleurs vendeurs par produit vendu par mois.


Référence: